deepfake影片:轉頭也不塌
上傳一段片子和一張清晰的臉。成品按原解析度返回,原始音軌完整保留,什麼都不用裝。
AI 換臉效果示例
一張清晰的人臉照片,一張目標照片,大約十秒出結果。以下都是上方同一個引擎生成的原始結果,沒有修圖。
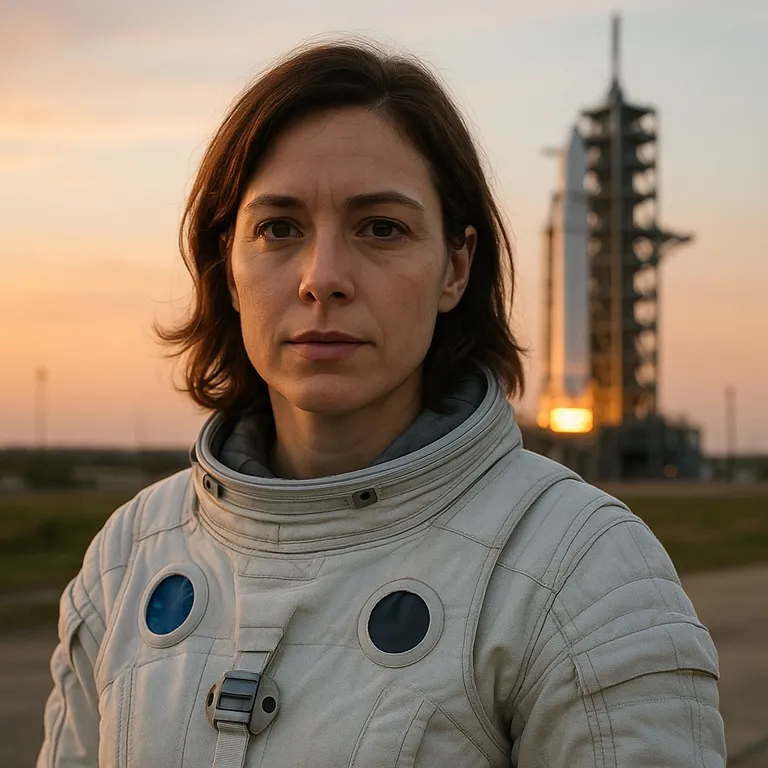 原圖
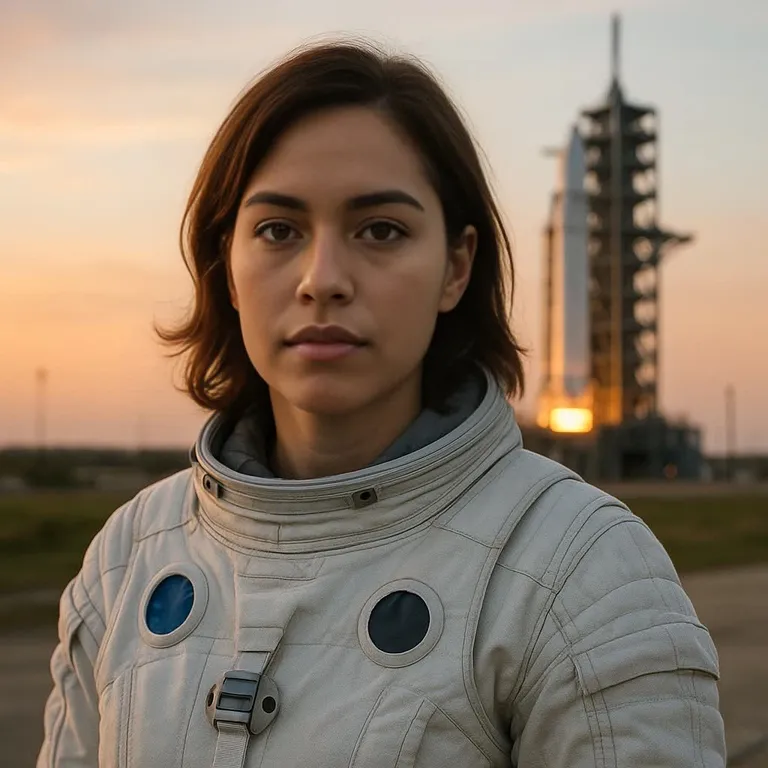 換臉後
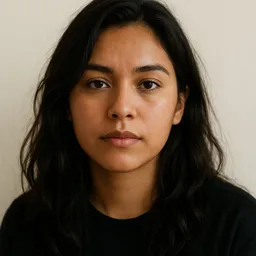
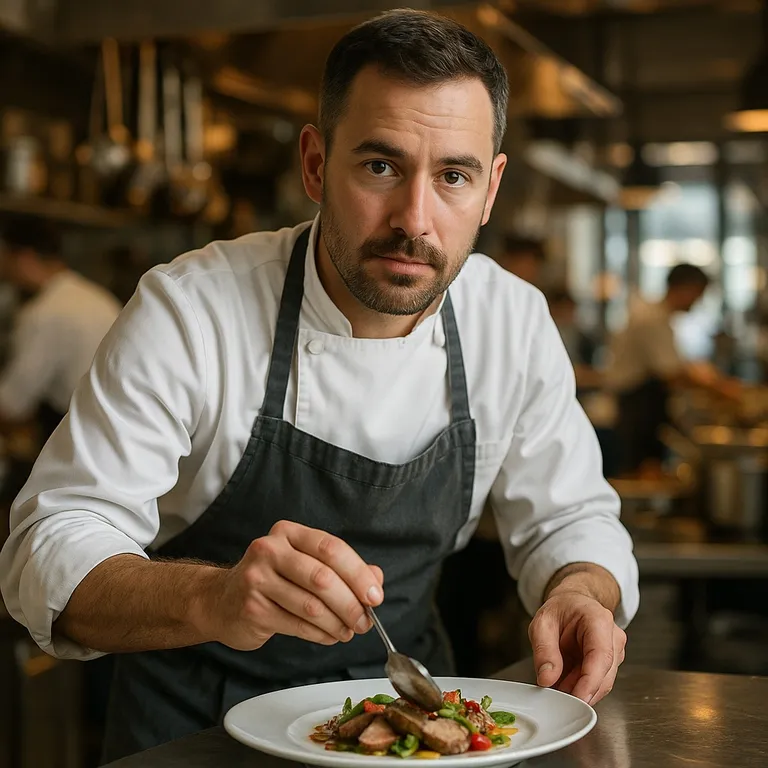 原圖
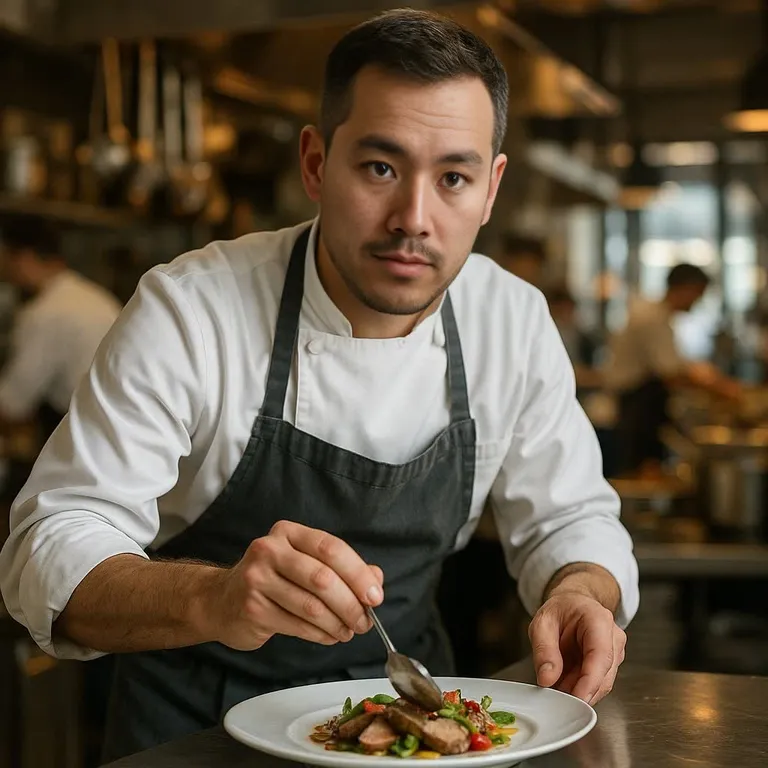 換臉後
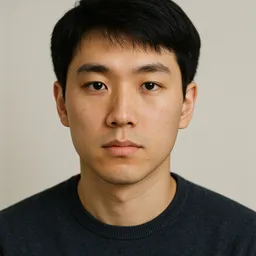
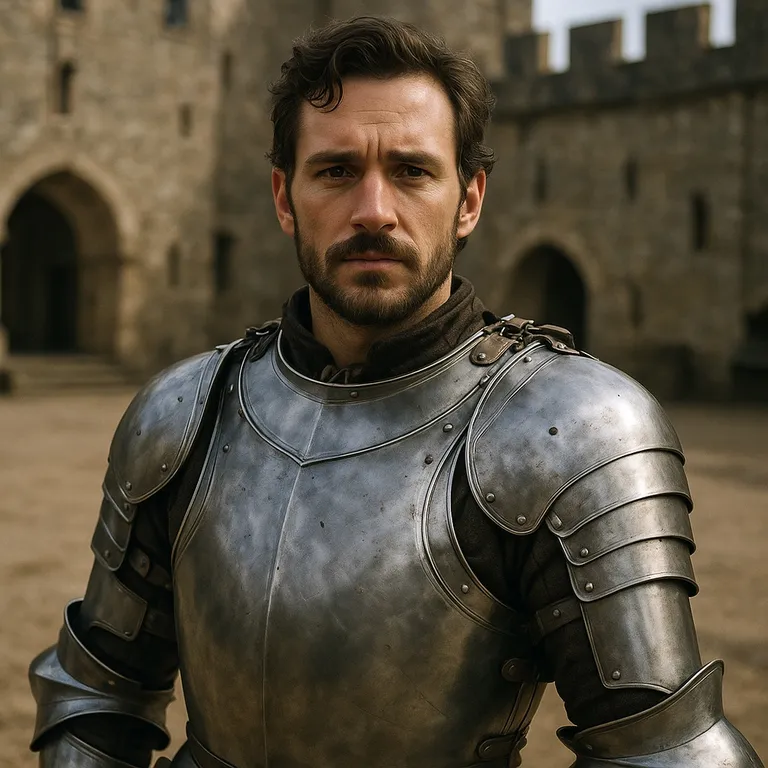 原圖
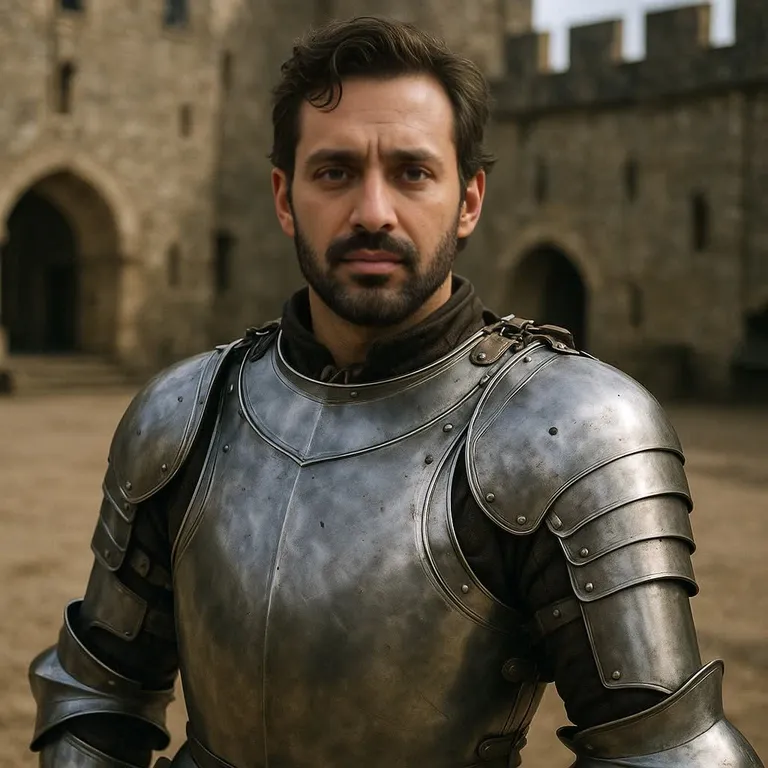 換臉後
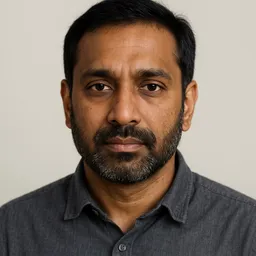
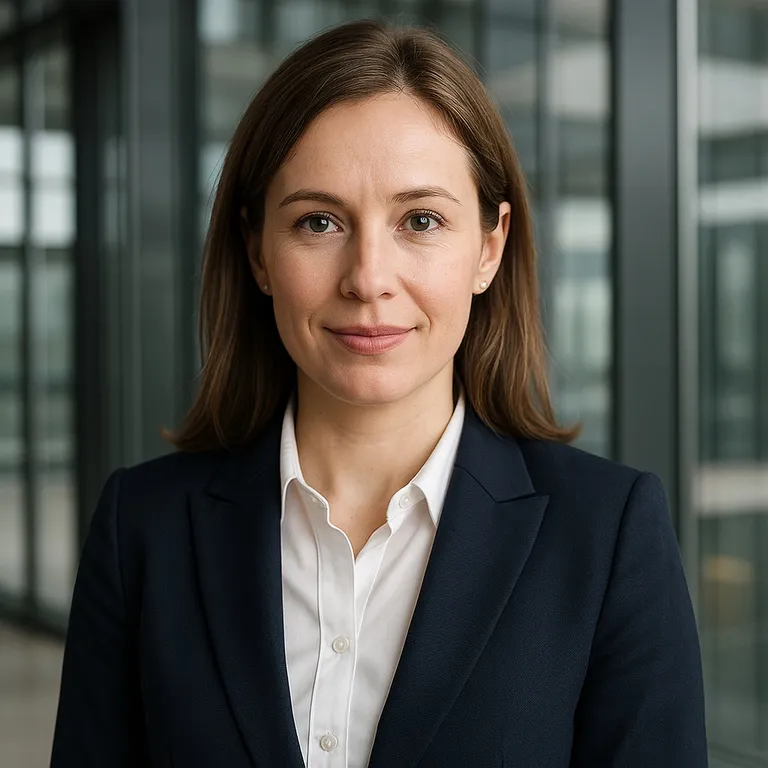 原圖
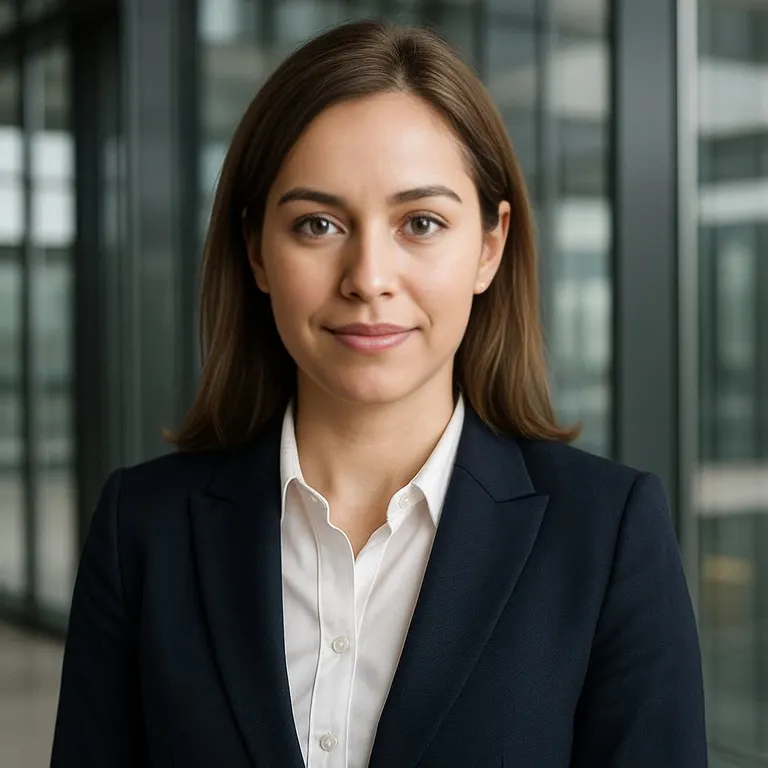 換臉後
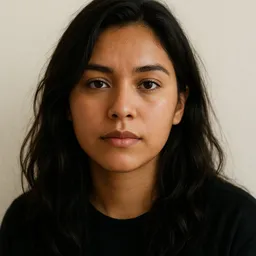
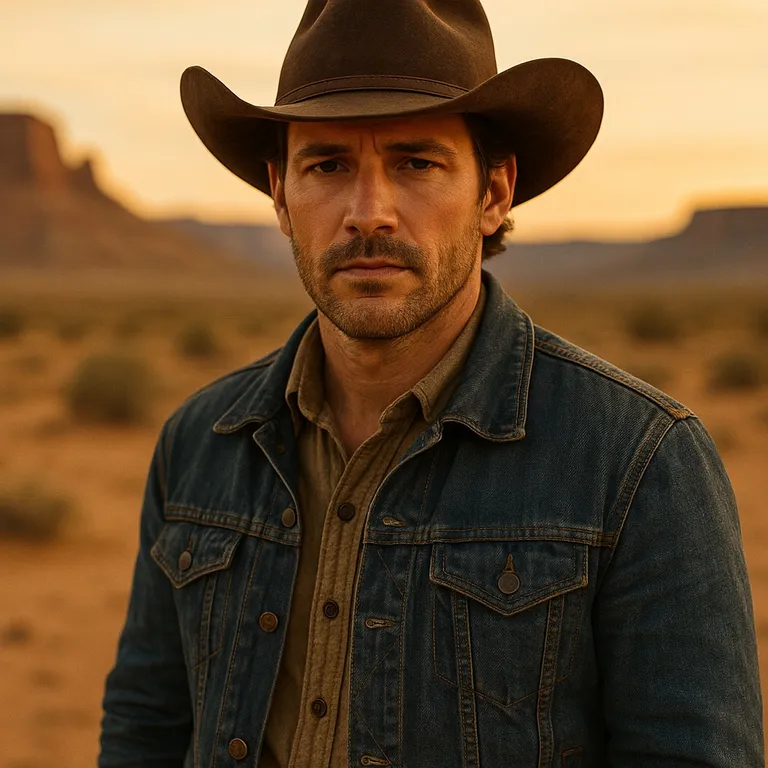 原圖
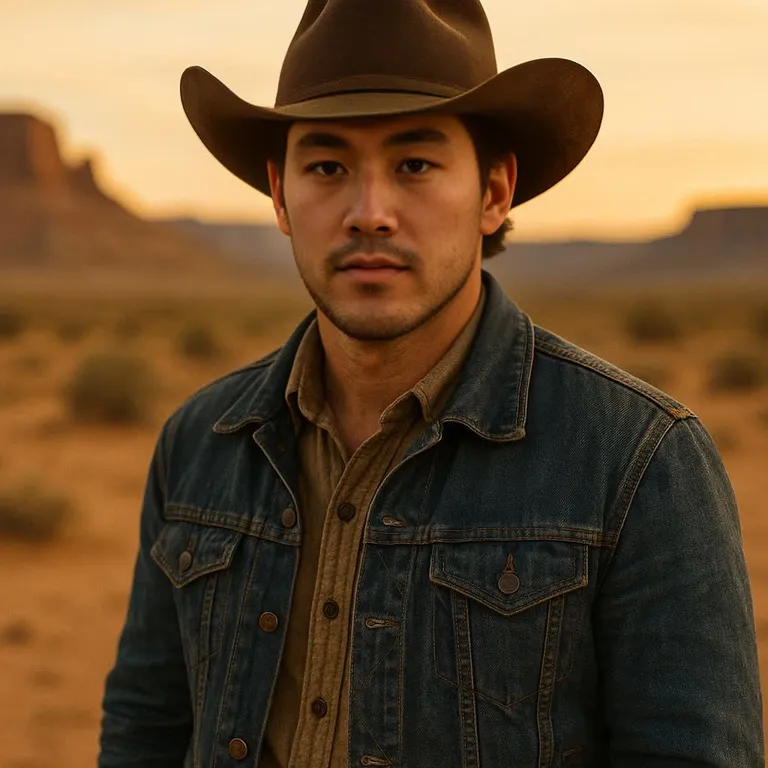 換臉後
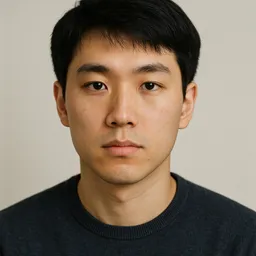
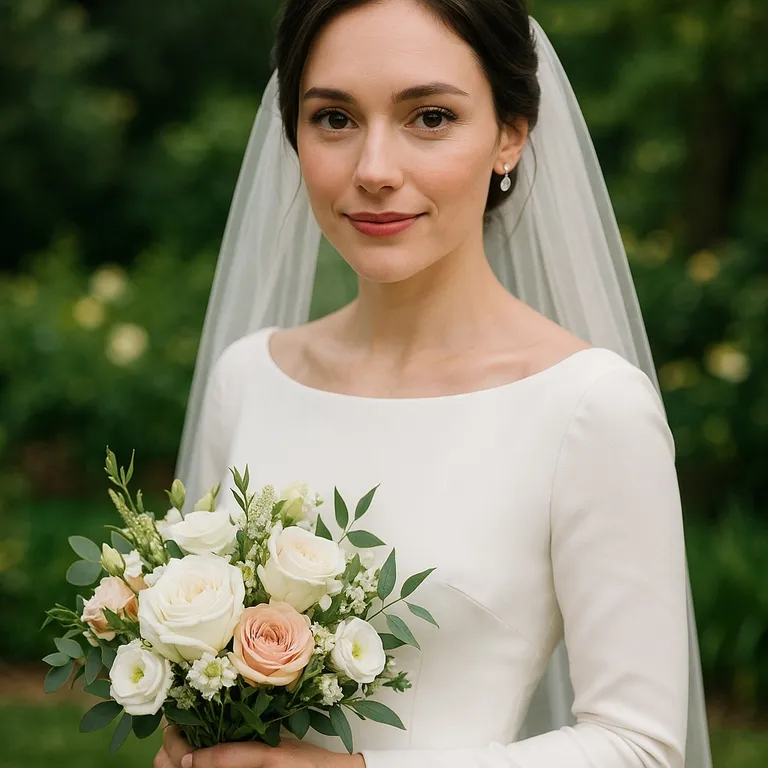 原圖
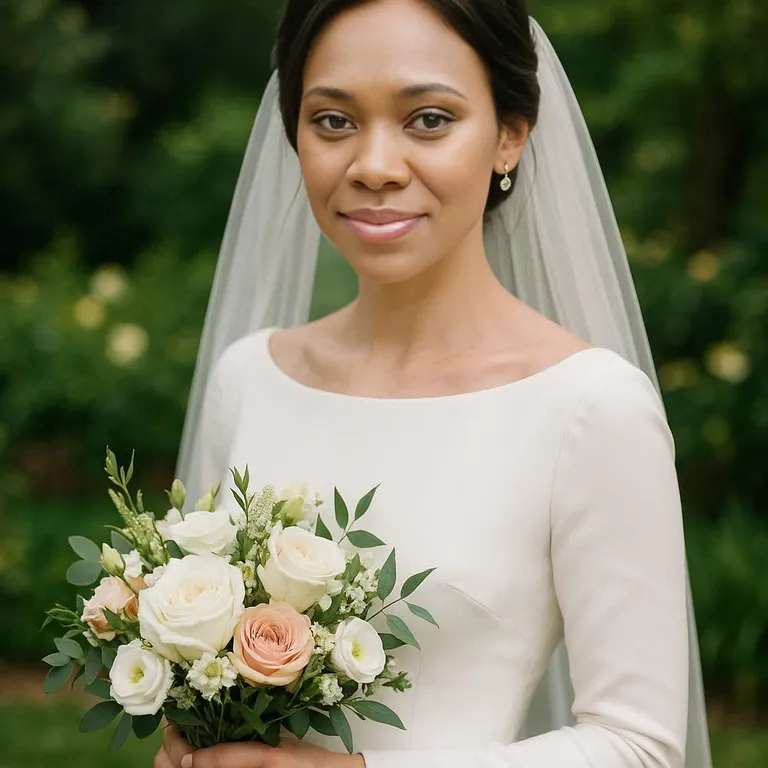 換臉後
示例中的所有人物均由 AI 生成,現實中並不存在。
deepfake影片就是你在照片上做過的那次人臉遷移,只不過要逐幀重複一遍,然後還得讓這些幀在時間軸上彼此對得上。後半句才是難點。一張靜止圖只需要自己成立;一條動態成品還得和前後二十九幀達成一致——人眼對細節的寬容度遠高於對跳動的寬容度,下頜線在兩幀之間挪動一個像素,觀眾立刻就讀得出來。
剩下的都是算術。十秒素材按每秒三十幀算,就是三百次獨立的人臉遷移;這就是為什麼deepfake影片以分鐘計,而照片以秒計,也是為什麼渲染時間跟的是幀數而不是檔案體積。同樣時長換成每秒六十幀,工作量直接翻倍。所以在按下渲染之前,把素材剪到真正承載想法的那一個鏡頭,是你能做的最有用的一件事。
你要準備的是一段 MP4 或 MOV,以及一張想放進去的人臉清晰正面照。偵測、關鍵點對齊、光線匹配、邊緣融合和重編碼都在這裡完成。音軌原樣通過,所以deepfake影片只改變臉,別的什麼都不動——沒有聲音複製,也沒有口型同步。不用裝任何東西,不需要你自己的顯示卡,上傳的檔案也不會進入訓練集。
輸入換成動態素材之後,有什麼不一樣
每一幀都單獨算一遍
不存在從首幀向後插值出來的軌跡。deepfake影片的每一幀都獨立完成偵測、對齊和融合,所以片子中間的硬切不會帶偏整段序列,人臉出畫之後再回來,也能被幹淨地重新接上。
轉頭時身分不散
主體一旦轉頭,模型上一幀還看得見的幾何資訊就沒了,只能重建。弱的deepfake影片正是在這裡崩掉:下頜在遊,髮際線在呼吸,整張臉每轉一次就搏動一下。能否在旋轉中守住身分,是觀眾最先察覺的那個破綻。
音軌完全不碰
這裡只換臉,別的都不動。原始聲音以原電平寫回成品,你拍到的那條表演就是你留下的那條。沒有聲音複製,沒有語音合成,沒有口型同步——嘴型跟的是當時真正拍下來的那一條。
原解析度,無預覽級降檔
回到你手上的檔案就是你上傳時的畫幅,不會為了逼你付費而縮水成一張小尺寸預覽。整條流程上唯一的畫質代價是那次重編碼,而它被壓到格式允許的最低限度,好讓deepfake影片不至於比進來時更難看。
不裝軟體,不用顯示卡,不排隊
整條 deepfake 流程跑在我們的硬體上。沒有桌面程式要設定,沒有模型權重要下載,沒有 Python 環境會被弄壞,也不用排隊。你在瀏覽器分頁裡上傳,幾分鐘後在同一頁取走成品。
怎樣做一條deepfake影片
先把片子剪短
挑出承載想法的那幾秒,上傳之前就剪到那裡。你留下的每一幀都是模型必須處理的一幀,所以八秒的緊湊鏡頭,會比整場戲更快變成一條做完的deepfake影片。
上傳一張清晰的臉
來源素材是靜態圖片而不是片段:一張正面照,雙眼可見,下頜線不被遮擋。這一張圖決定了隨後每一幀的身分,所以在這裡多花的功夫,會被放大幾百倍。
渲染,然後慢速回看
多數片子一到五分鐘完成,取決於幀數。先慢速播一遍再下判斷——暫停時看著完美無缺的deepfake影片,動起來仍然可能抖。
就這三步,而第一步最重要。如果成品不穩,答案幾乎總是換一個更穩的源鏡頭,而不是把同一段素材再渲染一遍。
什麼時候動態素材勝過一張照片
deepfake影片是一種形式,不是一個目的。下面這些場景值得多花那點渲染時間,而它們全都落在本頁下方那套同意規則之內。
對白與反應鏡頭
一張會說話、會眨眼、會有反應的臉,攜帶的資訊遠多於一張肖像,所以deepfake影片成立時比靜圖更有說服力,不成立時也塌得更徹底。鏡頭要短,機位要鎖死。
選角與提案素材
選角團隊需要看到演員動起來才能拍板。一版粗糙的成品五分鐘就能回答的問題,一張概念圖只能勉強比劃,而這發生在任何人簽字之前。
同人重剪與聯動剪輯
給一場戲換主角,把一段 cos 短片做完,或者攢出那支沒人出錢的聯動預告。剪到承載笑點的那個鏡頭就夠了——deepfake影片的成本一樣,但你的下午不一樣。
直式短影音
九秒直式用到的幀數只是完整一場戲的零頭,渲染很快。社交平台上的deepfake影片基本都活在這個長度上。
教人認出破綻
記者、教師和信任與安全團隊必須先看見動態裡的偽影,才認得出它們。親手做一條deepfake影片,盯著它在哪裡崩掉,比任何科普都快——偵測訓練要用生成素材,正是這個原因。
順著素材做,而不是跟它較勁
幀數就是全部的成本模型
deepfake影片的工作單位是幀,不是秒,更不是兆位元組。十二秒素材按每秒二十四幀算,是二百八十八次獨立的人臉遷移;同樣十二秒拍成每秒六十幀,就是七百二十次。兩個檔案在硬碟上可能一樣大,後者卻要多花兩倍半的時間。所以在決定上傳什麼的時候,數的應該是幀,不是秒。
這也讓剪輯成為你手上槓桿最高的那個決定。多數素材的想法只落在幾秒裡,周圍全是沒人需要的部分,而每一幀多餘的畫面都是白白花掉的處理時間。先剪,再渲染。粗略地說:十秒的成品大約一分鐘回來,一分鐘的素材要好幾分鐘,超過兩分鐘的最好按鏡頭拆開,只留你真正要用的那幾個。
廉價的deepfake影片為什麼會閃
閃爍不是融合環節的問題——正因為很多工具把它當成融合問題,它才那麼難纏。它來自偵測。有那麼幾幀,人臉糊了、轉得太過、或者半張臉落在陰影裡,偵測器沒有足夠把握認出它,這些幀就原樣通過,整條片子於是開始頻閃。三十幀裡混進一幀沒換的,當靜圖看根本發現不了,動起來卻刺眼——人的視覺本來就對時間上的變化,遠比對單幀裡的細節敏感。
三個可靠的成因:機位移動或快速轉頭帶來的運動模糊;一隻眼睛被鼻梁擋住的大側角;以及主體穿過光區時掃過臉部的陰影。三者都是素材的屬性,不是模型的屬性——這就是為什麼一個穩定、布光均勻的鏡頭第一次就能給出穩定的deepfake影片,而混合光下的手持鏡頭,無論重跑多少遍都很難。
像剪輯師那樣複查deepfake影片
下判斷之前,先用四分之一速度把成品看一遍,並且按固定順序檢查,而不是盯著整個畫面發呆。先看髮際線,尤其是轉頭的那幾幀——融合遮罩在那裡收尾,光暈或硬邊會最先在那裡暴露。然後是眨眼時的眼睛、說話時的牙齒、轉頭時的頸部接縫,最後是耳朵,模型經常把它抹成一團在側臉裡站不住的形狀。
最後要考慮的是交付。你上傳到的任何平台都會再壓一遍,而壓縮最先吃掉的,恰好是融合邊緣周圍那些高頻細節。在你自己播放器裡沒問題的deepfake影片,被社交平台處理完之後,可能在下頜一帶出現明顯的塊效應。所以匯出時用平台允許的最高畫質,把降質這件事留給平台去做。
挑一段deepfake影片用得上的素材
那張來源圖片值得的注意力,比它的檔案體積暗示的要多。一張銳利的正面幀——雙眼可見,不戴墨鏡,下巴前沒有橫著的話筒,正面受光而不是單側硬光——決定了成品裡每一幀繼承的身分。參考圖偏軟或偏側,不是讓結果略微變差,而是讓每一幀同等地變差。
目標片段要看的是人臉隨時間怎麼變化,而不是某一幀好不好看。留意主體走遠時人臉變小、一隻手或一個杯子從臉前掠過、以及畫面裡還有第二個人可能被偵測器盯上。人臉大小基本不變、不被遮擋、且只有一個人的鏡頭,比更好看卻違反其中任一條的鏡頭,更可靠地給出一條可用的deepfake影片。
- 渲染之前,先剪到承載想法的那一個鏡頭
- 優先用鎖死的機位——手持帶來的運動模糊是閃爍的頭號原因
- 讓人臉在整段片子裡都保持可用的大小,而不只是開頭那一幀
- deepfake影片的來源人臉只用一張銳利的正面靜態圖
- 避開有手、話筒或頭髮橫穿臉部的鏡頭
- 發布之前,用四分之一速度把成品完整過一遍
對每一段素材都適用的規則
性相關與色情的deepfake影片內容在這裡被禁止。不是不鼓勵,也不是放在某個付費檔後面——是禁止,在模型層就被過濾,嘗試者的帳號會失去存取權限。沒有任何設定、檔位或變通手段能改變這一點。無論被呈現的人是不是名人,禁令一律適用——未經同意的私密影像正是這項技術傷害最大的地方。
第二條規則關於呈現方式。作為明顯編輯發布的deepfake影片是戲仿、評論或同人創作,這三者都正當;同一個檔案被當作真實影像發布就是欺騙,而在越來越多的司法轄區,這已經違法——選舉誠信法規、未經同意私密影像法和肖像權都能管到它,提起訴訟的國家每年都在變多。把編輯過的素材標註清楚;商業用途之前先取得肖像授權;當事人提出下架要求,我們會照辦。
deepfake影片常見問題
一條deepfake影片要渲染多久?
多數片子一到五分鐘。決定時間的是幀數而不是檔案體積:十秒、每秒三十幀就是三百次運算,通常一分鐘左右回來;拍成每秒六十幀,時間翻倍。
可以上傳什麼?片子能多長?
素材是 MP4 或 MOV,不超過 100MB;來源人臉是一張不超過 10MB 的靜態圖片。時長只受這個體積限制,但片子越長幀數越多——把deepfake影片剪到你真正需要的鏡頭,永遠更快。
聲音會變嗎?
不會。音軌以原電平原樣寫回。這裡的deepfake影片只做人臉遷移:沒有聲音複製,沒有語音合成,沒有口型同步,嘴型跟的是當時拍下來的那條表演。
我的deepfake影片為什麼會閃?
因為偵測器在某些幀上丟了人臉。運動模糊、大角度側轉、掃過臉部的陰影,是三個常見原因,而它們都出自素材而非模型。換一個更穩、布光更均勻的鏡頭就能解決。
有浮水印嗎?我的檔案會怎樣?
成品右下角帶一個很小的 aideepfake.io 標識,任意付費——點數包或訂閱都算——就能去掉;開關就在工具裡,寫著「付費後可去除」,上傳之前你就看得見。解析度不受影響,deepfake影片按你上傳的尺寸返回。你的人臉參考圖和素材只用於這一次渲染——不進訓練資料,不轉賣,不發布。你做的deepfake影片始終屬於你。
可以做露骨或色情內容嗎?
不可以。性相關的deepfake影片內容被徹底禁止,在模型層就被過濾,並且構成立即失去存取權限的理由。沒有任何方案、設定或客服申請能改變這一點,無論那張臉是不是名人。
做deepfake影片合法嗎?
完全取決於你拿它做什麼。戲仿、評論、研究和明確標註的同人作品,在多數司法轄區受保護。把deepfake影片冒充成真實影像就是欺騙,在越來越多的司法轄區已屬違法;性內容與未經肖像授權的商業使用同樣如此。